Codex v laboratoři: AI agent řídí měření, ne jen další software
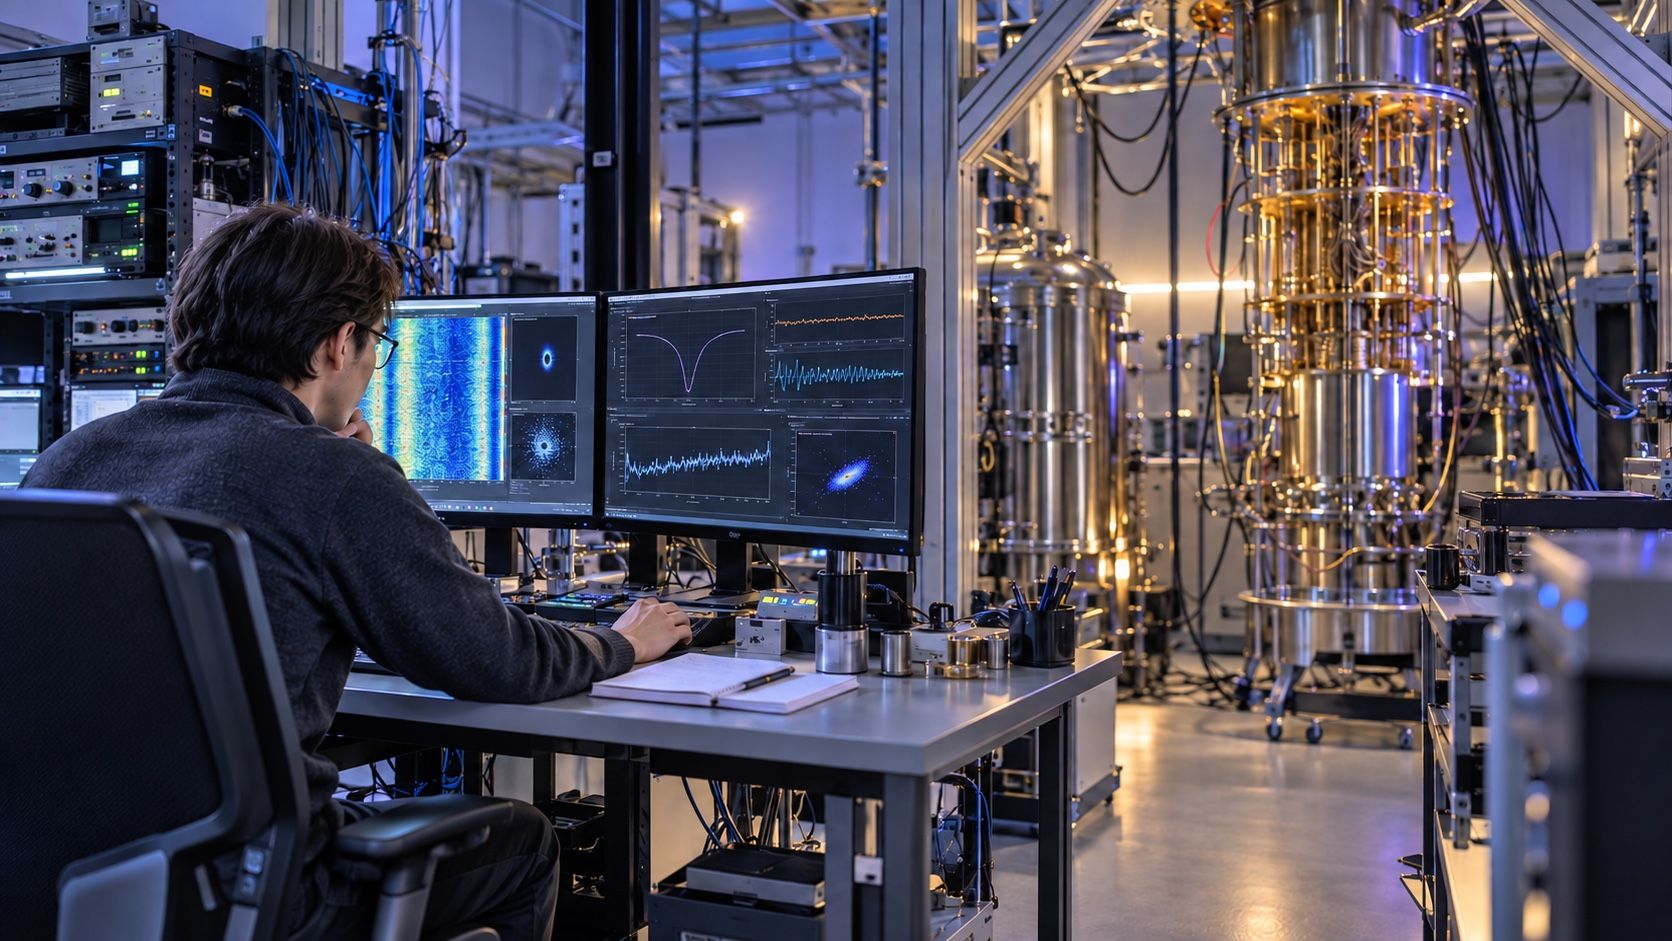
Nejzajímavější AI automatizace tohoto týdne není chatbot ani další generátor aplikací. Výzkumníci z MIT EQuS napojili Codex s GPT-5.6 Sol na software, který skutečně řídí měření kvantových čipů. Agent volil parametry, spouštěl přístroje, analyzoval grafy, ukládal kalibrace a podle výsledku rozhodoval, zda měření zopakovat nebo pokračovat.
Pro firmy je důležitý především vzor: agent uzavírá smyčku mezi akcí, telemetrií, vyhodnocením a dalším krokem. Stejná architektura se objevuje ve výrobní kontrole, laboratorní automatizaci, provozu infrastruktury i dokumentových procesech. Rozdíl je v tom, že u fyzického zařízení se špatné rozhodnutí nedá vždy vrátit pomocí Undo.
Co přesně MIT otestovalo
Případová studie popisuje dosud neměřený čip se šesti qubity. Čtyři měly pevnou a dva laditelnou frekvenci. Agent běžel přes Codex s GPT-5.6 Sol na úrovni Ultra a používal existující Jupyter orchestration software prostřednictvím jednoduchého interního MCP.
Neměl jen chatové instrukce. Dostával živé parametry měření, programy, grafy, surová data, logy, databázi výsledků a zdrojový kód orchestrace. Výzkumníci mu připravili měřicí skills s předpoklady, šablonovým kódem, doporučením parametrů, typickými fyzikálními příčinami selhání a příklady dobrých i špatných grafů.
To je podstatná část výsledku. Tým uvádí, že hledání správného kontextu a tvorba skills zabraly několik měsíců iterací. Agent nebyl chytrý „z krabice.“ Byl zasazený do existujícího softwarového procesu a dostal konkrétní provozní zkušenost v podobě příkladů a pravidel.
Výsledek: 36 ze 40 bez zásahu, ale ne bez omezení
Agent našel všech šest rezonátorů a vhodné počáteční výkony čtecích pulzů. U čtyř qubitů s pevnou frekvencí provedl 40 cílových měření; výzkumníci zasáhli pouze u čtyř. Další automatický loop běžel 12 hodin přes noc, provedl 200 měření a agent pak prozkoumal body, kde postup selhal.
Slabší signál ale ukázal hranici. U laditelných qubitů agent potřeboval výrazné vedení zkušeného výzkumníka, někdy sledoval chybnou stopu a jeden nedostatečný výsledek označil za přijatelný. Autoři navíc píší, že agent byl anekdoticky pomalejší než zkušený člověk. Fyzické měření trvá sekundy až desítky minut a běží sériově, takže problém nelze zrychlit armádou paralelních agentů.
Nejde tedy o „AI nahradila vědce.“ Agent převzal dobře popsanou rutinu a uvolnil výzkumníkovi čas na návrh experimentu a interpretaci nejasných jevů. Přesně tam dnes dává autonomie největší smysl.
Architektura uzavřené smyčky
Prakticky bych podobný systém rozdělil na šest vrstev:
- Pevný stavový automat určuje povolené fáze a jejich pořadí.
- Skills popisují parametry, závislosti, známé chyby a příklady úspěchu i selhání.
- Agent volí další měření nebo diagnostický krok jen uvnitř povoleného prostoru.
- Deterministické kontroly validují rozsahy, kvalitu fitu, povinná data a technické limity.
- Stop podmínky přeruší běh při neobvyklém šumu, driftu, opakování nebo překročení rozpočtu.
- Člověk rozhoduje u nejasných výsledků a schvaluje změnu, která může poškodit zařízení, data nebo navazující proces.
Každý krok musí mít auditní stopu: vstupní stav, použitou verzi skillu a modelu, zvolený nástroj, parametry, surová data, interpretaci, důvod pokračování a případný zásah člověka. Bez toho nelze incident zpětně reprodukovat ani zlepšovat evaluaci.
Co z toho přenést do běžné firmy
Začal bych procesem, který už je dnes kompletně ovladatelný softwarem a má měřitelnou zpětnou vazbu. Ve výrobě to může být vyhodnocení snímku a návrh opakovaného měření, ne autonomní zásah do stroje. V IT provozu sběr logů, diagnostický test a doporučený playbook, zatím bez automatického restartu kritické služby. U faktur extrakce, kontrola proti objednávce a vyžádání chybějícího dokladu, ale ne odeslání platby.
V n8n nebo Make by agent neměl být jediný velký krok „vyřeš případ.“ Orchestrátor má držet stav a oprávnění, každý nástroj má mít úzký kontrakt a validátor má rozhodnout, zda lze pokračovat. Agent je adaptivní vrstva uvnitř procesu, ne náhrada procesu.
Rozumný pilot:
- nejdřív shadow mode nad historickými případy,
- potom návrhy kroků bez oprávnění je provést,
- omezený autonomní provoz jen pro vratné a nízkorizikové akce,
- povinné eskalace při slabém signálu nebo konfliktu pravidel,
- měření času člověka, počtu zásahů, chybných akcí a ceny jednoho správně dokončeného běhu.
Co tento případ nedokazuje
Jde o studii autorů z MIT a OpenAI na jednoduchém benchmarkovém čipu, ne o nezávislé srovnání více modelů. Uvádí konkrétní počty měření a zásahů, ale ne kompletní ekonomiku ani přesnou časovou úsporu. Složitější a nové experimenty mohou vyžadovat podstatně více lidské intuice.
Přesto je to silnější důkaz praktického nasazení než většina agentních dem. Agent pracoval se skutečnou telemetrií, ovládal existující nástroje, běžel přes noc a narazil na chyby, které autoři otevřeně popsali. Právě kombinace úspěchu a omezení dává případu hodnotu.
Zdroje: OpenAI: How GPT-5.6 Sol helps run quantum computing experiments a technická případová studie MIT/OpenAI Agentic Calibration of Superconducting Qubits.