Lokální AI agenti: Ollama v Claude Code a Codexu, data i limity
Aktualizace 24. září 2026: vlastní model ve známém agentovi přes Ollama
Filip Oborník ve videu z 23. září ukazuje užitečné oddělení: aplikace agenta nemusí určovat poskytovatele modelu. Pro tento článek jsem ověřil terminálovou cestu v dokumentaci; datum videa není doložené datum prvního vydání integrace.
Ollama pro Claude Code používá Anthropic-kompatibilní API. Integrace Codex CLI má vlastní profil a katalog modelů. Po instalaci Ollama a příslušného CLI spusťte jednu z variant:
ollama launch claude
ollama launch codex
Ve výběru zkontrolujte konkrétní model a místo inference. Ollama nabízí i cloudové modely; samotný příkaz proto nedokazuje lokální zpracování. OpenAI také dokumentuje volbu vlastního model providera a Ollama pro OSS režim.
Obě integrace doporučují alespoň 64k kontextu. Dlouhé okno však musí unést hardware. Pomocí ollama ps lze podle FAQ ověřit, zda model běží na GPU, CPU nebo kombinaci. Schopnost otevřít chat ještě nepotvrzuje spolehlivé použití nástrojů a úpravy souborů.
Pilot na citlivém repozitáři
Začal bych izolovanou kopií interního parseru faktur a anonymními testovacími vstupy. Agent má opravit konkrétní chybu, spustit testy a vrátit diff. Nemá přihlašovací údaje do účetnictví ani právo odesílat dokumenty.
Zaznamenejte model, kvantizaci, kontext, čas, počet oprav a výsledek testů. Vedle funkčnosti sledujte, zda agent znovu neprovádí dokončenou práci. Při opakovaném selhání ho zastavte; nenechte levný běh spotřebovat hodiny review.
Pro citlivá data zkontrolujte celý tok: modelový endpoint, MCP, vyhledávání, síťové nástroje i cloudový fallback. Omezení sítě nastavujte mimo prompt. Lokální inference nemůže zabránit nástroji, aby samostatně poslal dokument ven.
Tato integrace usnadňuje výměnu modelu a pilot na vlastním hardwaru. Sama nenahrazuje firemní gateway s rozpočty, správou přístupů a auditem. Níže zůstávají starší případové studie; jejich konkrétní výsledky a ceny patří k uvedeným datům.
Aktualizace 2. září 2026: lokální AI je hlavně rozhodnutí o datech, ne trik na levnější tokeny
Nový praktický test Jirky Herníka posouvá tento článek od coding benchmarku k otázce, kterou ve firmách řeším častěji: co dělat, když agent potřebuje faktury, e-maily, bankovní export nebo interní dokumenty, které nechcete posílat do běžného cloudového chatu.
V testu běžel Qwen3.8‑27B v čtyřbitové kvantizaci na RTX 3090 s 24 GB VRAM. Lokální model přes Unsloth Studio a OpenCode zpracoval CSV s historií plateb a postavil HTML dashboard. Po odpojení internetu pokračoval dál. To je důležitý důkaz proveditelnosti, ale ne univerzální benchmark: jde o jednu sestavu, jedno zadání a konkrétní nastavení.
Anonymizace není smazané jméno
Nejdřív je potřeba oddělit tři různé strategie:
- Anonymizace má znemožnit rozumně pravděpodobnou identifikaci člověka. Nestačí odstranit jméno, pokud kombinace města, profese, věku a neobvyklého chování člověka stále prozradí.
- Pseudonymizace nahradí identifikátor například číslem zákazníka, ale převodní tabulka zůstává odděleně. Podle EDPB jsou pseudonymizovaná data stále osobní data a GDPR se na ně dál vztahuje.
- Lokální zpracování drží prompt, dokumenty i inference na vlastním zařízení. LM Studio uvádí, že při lokálním běhu se zprávy, historie a dokumenty ze zařízení nepřenášejí; aplikace může fungovat i offline po předchozím stažení modelu.
Tyto strategie se mohou kombinovat. Například n8n může před lokální extrakcí nahradit rodná čísla interními ID, lokální model vytvoří strukturované JSON a až schválený souhrn se odešle do CRM. Pseudonymizace ale sama z cloudového zpracování neudělá anonymní ani bezrizikovou operaci.
Tři prostředí, ne dvě
Praktická volba není jen cloud versus vlastní počítač:
- Vlastní hardware drží data i inference uvnitř vaší hranice. Dává smysl pro citlivé dokumenty, opakovanou extrakci, interní vyhledávání nebo provoz bez internetu.
- API je nejjednodušší na nasazení a škálování. U citlivých dat musíte řešit poskytovatele, region, retention, smlouvy a to, které nástroje agent smí volat.
- Pronajaté GPU může být levnější než nákup železa, ale není lokální. Data opouštějí vaši infrastrukturu a bezpečnostní model se podobá cloudu.
Lokální aplikace navíc nemusí znamenat lokální workflow. Pokud agent používá webové vyhledávání, cloudový fallback, telemetrii nebo vzdálené MCP, část dat může hranici opustit. Pro skutečně citlivý běh proto nastavte egress pravidla, vypněte nepotřebné nástroje a logujte, kam agent komunikuje.
Výkon se nevejde do jediného čísla
Qwenův model card uvádí 27 miliard parametrů, nativní kontext 262 144 tokenů, možnost rozšíření k jednomu milionu a licenci Apache 2.0. To ale neznamená, že tuto konfiguraci pohodlně rozběhnete na každém 24GB GPU. Do VRAM se musí vejít kvantizované váhy, KV cache, kontext a režie inference.
V předchozím testu se čtyřbitový model vešel do 24GB RTX 3090, ale při delší agentní smyčce ztratil průběžný stav a opakoval hotovou práci. Nový test ukázal stejnou hranici z jiné strany: při extra vysokém reasoning se model zacyklil kvůli formátování čísla, došel kontext a proběhla kompaktace. Proto je u lokálního agenta stejně důležitý perzistentní task state, acceptance test a stop podmínka jako velikost modelu.
Kdy se vlastní GPU zaplatí
Ve videu postavil stejný dashboard cloudový GLM‑5.3‑Flash přibližně za 0,20 Kč. Beru to jako údaj z jedné case study, ne jako ceník. OpenRouter aktuálně uvádí akční cenu 0,075 USD za milion vstupních a 0,25 USD za milion výstupních tokenů; cena se může změnit.
Pokud kupujete GPU jen proto, abyste ušetřili několik haléřů na jednotlivém workflow, návratnost bude slabá. Lokální provoz se obvykle obhajuje jinak:
- data nesmějí opustit zařízení nebo firemní síť,
- workflow běží často a stabilně,
- potřebujete nízkou a předvídatelnou latenci,
- internet nebo externí API nemusí být dostupné,
- stejný hardware využije více procesů, ne jeden občasný agent.
Do kalkulace patří pořizovací cena, elektřina, chlazení, správa, čas při chybách, lidské review a fallback. Správná metrika není cena tokenu ani tokeny za sekundu, ale cena schváleného výsledku.
Jak bych to nasadil
Pro faktury, e-maily nebo CRM enrichment bych začal malým pilotem:
- Sepište, která pole jsou citlivá a která smějí opustit vaši hranici.
- Připravte 50–100 reprezentativních dokumentů včetně výjimek.
- Spusťte lokální model přes LM Studio nebo Unsloth Studio za OpenAI-kompatibilním API.
- Výstup držte ve strukturovaném JSON, kontrolujte schéma a ukládejte auditní stopu.
- Nízkou jistotu nebo drahou výjimku pošlete člověku; cloudový fallback používejte jen pro pole, která ho smějí opustit.
- Porovnejte cenu, latenci a chybovost na dokončený a schválený případ.
Lokální AI tedy není automaticky levnější ani automaticky bezpečná. Je to jiná provozní hranice. Pokud ji doplníte o omezené nástroje, síťová pravidla, perzistentní stav a měřitelné acceptance testy, může být pro citlivé firemní workflow velmi praktická.
Zdroj nové case study: Jirka Herník – Jak na AI na vašem počítači.
Aktualizace 21. srpna 2026: silnější lokální model narazil na kontext, ne na syntaxi
Jirka Herník se k Tetris testu vrátil s výrazně silnější sestavou: Qwen3.8‑27B v kvantizaci Q4_K_M, RTX 3090 s 24 GB VRAM, LM Studio a opencode. Podle jeho měření se 17,74GB model na této kartě dostal zhruba na 800 tokenů za sekundu při zpracování vstupu a 40 tokenů za sekundu na výstupu. Beru to jako praktickou case study konkrétní sestavy, ne jako univerzální benchmark.
Důležitější než rychlost je ale způsob selhání. Agent podle testu psal Tetris znovu a znovu, protože při zaplnění kontextu používal LM Studio politiku truncateMiddle. Ta ponechá systémový prompt a první uživatelskou zprávu, ale zahazuje zprávy uprostřed. Model tedy mohl dál znát původní zadání, ale ztratil informaci, že už aplikaci vytvořil a co má teď ověřovat.
To odpovídá oficiální dokumentaci LM Studia: při přetečení lze generování zastavit (stopAtLimit), zkrátit střed konverzace (truncateMiddle) nebo držet posuvné okno (rollingWindow). Žádná volba sama o sobě neudělá dlouhého agenta spolehlivým. Musíte vědět, která část historie může zmizet, a pracovní stav uložit mimo chat.
Oficiální model card Qwen3.8‑27B uvádí 27 miliard parametrů, nativní kontext 262 144 tokenů a možnost rozšíření až na milion. To ale není totéž jako kontext, který skutečně poběží v lokální kvantizaci na konkrétní kartě. V praxi do limitu vstupuje VRAM, nastavení serveru, KV cache i agentní nástroje.
Co z toho nastavit v reálném workflow
- Kontextovou délku a overflow politiku nastavte vědomě; nespoléhejte na default.
- Plán, dokončené kroky a otevřené chyby ukládejte do repozitáře nebo strukturovaného task state, ne jen do konverzace.
- Přidejte stop podmínku: pokud agent opakovaně mění stejné soubory a nezlepšuje testy, smyčku ukončete a eskalujte.
- Měřte cenu za dokončený úkol včetně opakování a lidské kontroly, ne jen tokeny za sekundu nebo cenu modelu.
- Lokální model pouštějte nejdřív na izolovaném úkolu s automatickým acceptance testem a cloudovým či lidským fallbackem.
Nový test tedy neposouvá závěr článku směrem k „lokální modely už nahradily cloud“. Posouvá ho jinam: model je jen jedna část agentního systému. Silnější GPU a novější váhy pomohou, ale bez perzistentního stavu, správné práce s kontextem a verifikace můžete pouze rychleji opakovat stejnou chybu.
Zdroj case study: Jirka Herník – Naklonoval jsem se 10x, AI Mastermind 36.
Jirka Herník 16. května 2026 udělal přesně ten typ testu, který je pro AI praxi užitečnější než další tabulka benchmarků: vzal šest lokálních modelů, jednu cloudovou baseline a všem dal stejné zadání. Napiš Tetris jako jeden HTML soubor.
Běželo to na běžně dosažitelném, ale pořád silném domácím stroji: Ryzen 9 5950X, RTX 3070 s 8 GB VRAM, 128 GB RAM a LM Studio jako lokální server. Do toho opencode jako coding agent, Playwright MCP pro kontrolu v prohlížeči a cloudová GPT-5.5 přes OpenRouter jako referenční výsledek.
Proč je to dobrý test
Tetris není enterprise aplikace, ale je lepší test než „vypiš mi TODO appku“. Model musí držet stav hry, rotace, kolize, vykreslování, časování, vstup z klávesnice a chyby v JavaScriptu. Když má výstup běžet jako jeden HTML soubor, není moc kam schovat rozbitou architekturu.
Co dopadlo špatně
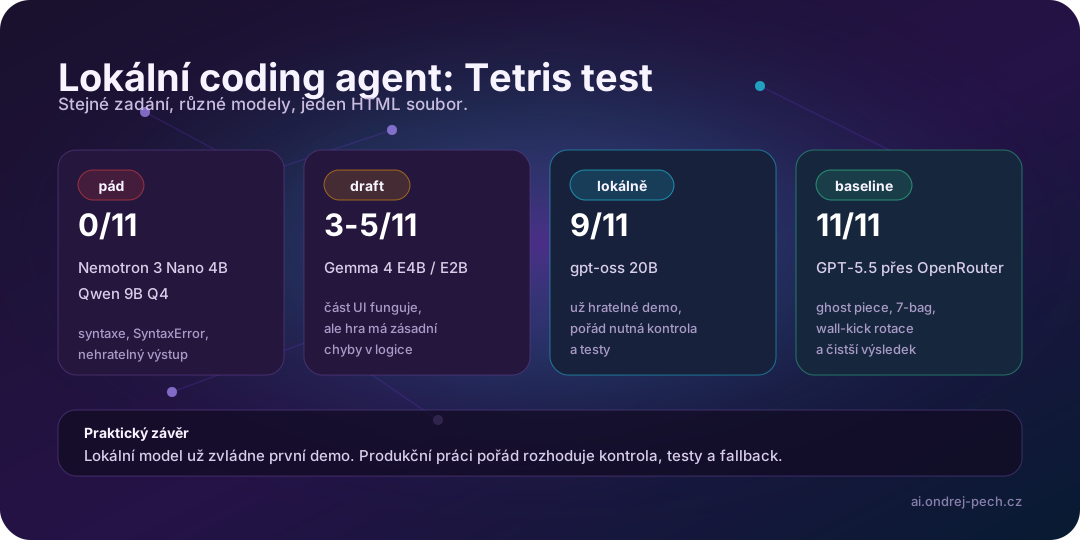
Nejmenší modely narazily rychle. Nemotron 3 Nano 4B podle videa vrátil Pythonovskou syntaxi uvnitř JavaScriptu a skončil na 0/11. Qwen 9B Q4 spadl na SyntaxError a také skončil na 0/11.
To není ostuda těch modelů. Je to připomínka, že „lokální AI“ není jedna kategorie. Model, který dobře odpovídá v chatu nebo zvládne jednoduchou extrakci, ještě nemusí být použitelný jako coding agent, který má vytvořit funkční interaktivní aplikaci.
Kde už lokální model začíná dávat smysl
Zajímavější je prostředek. Gemma 4 E4B skončila na 3/11 a Gemma 4 E2B na 5/11, i když u ní byla aktivní kostka neviditelná. To zní komicky, ale pro praxi je to důležité: lokální model se už může hodit na návrhy, dílčí úpravy, refaktoring jednoduchých částí, vysvětlení kódu nebo první draft.
Skutečně zajímavý výsledek byl gpt-oss 20B. Ten podle testu zvládl 9/11 a hra byla opravdu hratelná. To je hranice, kde už lokální model není jen hračka. Pořád bych ho nepustil bez kontroly na produkční kód, ale jako levný pracovní model pro první iteraci začíná dávat smysl.
Proč cloudová baseline pořád vyhrála
GPT-5.5 přes OpenRouter zvládla 11/11: ghost piece, 7-bag randomizer i wall-kick rotace. To je přesně rozdíl mezi „nějak to běží“ a „rozumí tomu jako malé aplikaci“.
Z toho plyne praktické pravidlo: lokální model může být levná první vrstva, ale těžké případy, finální review a složitější architektura pořád patří silnějšímu modelu. Ne proto, že cloud je magický. Protože schopnost udržet více pravidel a edge casů najednou je u coding agenta zásadní.
Jak bych to použil ve workflow
Lokální model bych dnes použil takhle:
- jednoduché generování boilerplate,
- vysvětlení cizího kódu,
- první návrh malé funkce,
- rychlé refaktoringy bez citlivých dat,
- předzpracování úloh před dražším modelem.
Silnější model nebo cloudovou baseline bych nechal na:
- návrh architektury,
- složité opravy,
- testy a edge cases,
- finální review,
- rozhodnutí, kde chyba stojí víc než tokeny.
Závěr
Tenhle test není o tom, že lokální AI prohrála. Spíš ukazuje, že lokální AI konečně začíná být praktická, jen se musí správně zařadit do workflow.
RTX 3070 s 8 GB VRAM ještě není náhrada frontier modelu. Ale už je to dost na to, aby lokální agent udělal první kus práce, levně a bez posílání všeho do cloudu. Produkční hodnota ale nevzniká tím, že jeden model zvládne Tetris. Vzniká tím, že máte router, testy, fallback a člověka, který pozná rozdíl mezi hratelným demem a spolehlivým softwarem.
Zdroje: Jirka Herník: Tetris od 6 lokálních AI, LM Studio, opencode, Playwright MCP, OpenRouter, OpenAI: gpt-oss, Google Gemma, Qwen, NVIDIA Nemotron.