Perplexity Photon: levnější hledání pro AI agenty, které musí projít vlastním testem
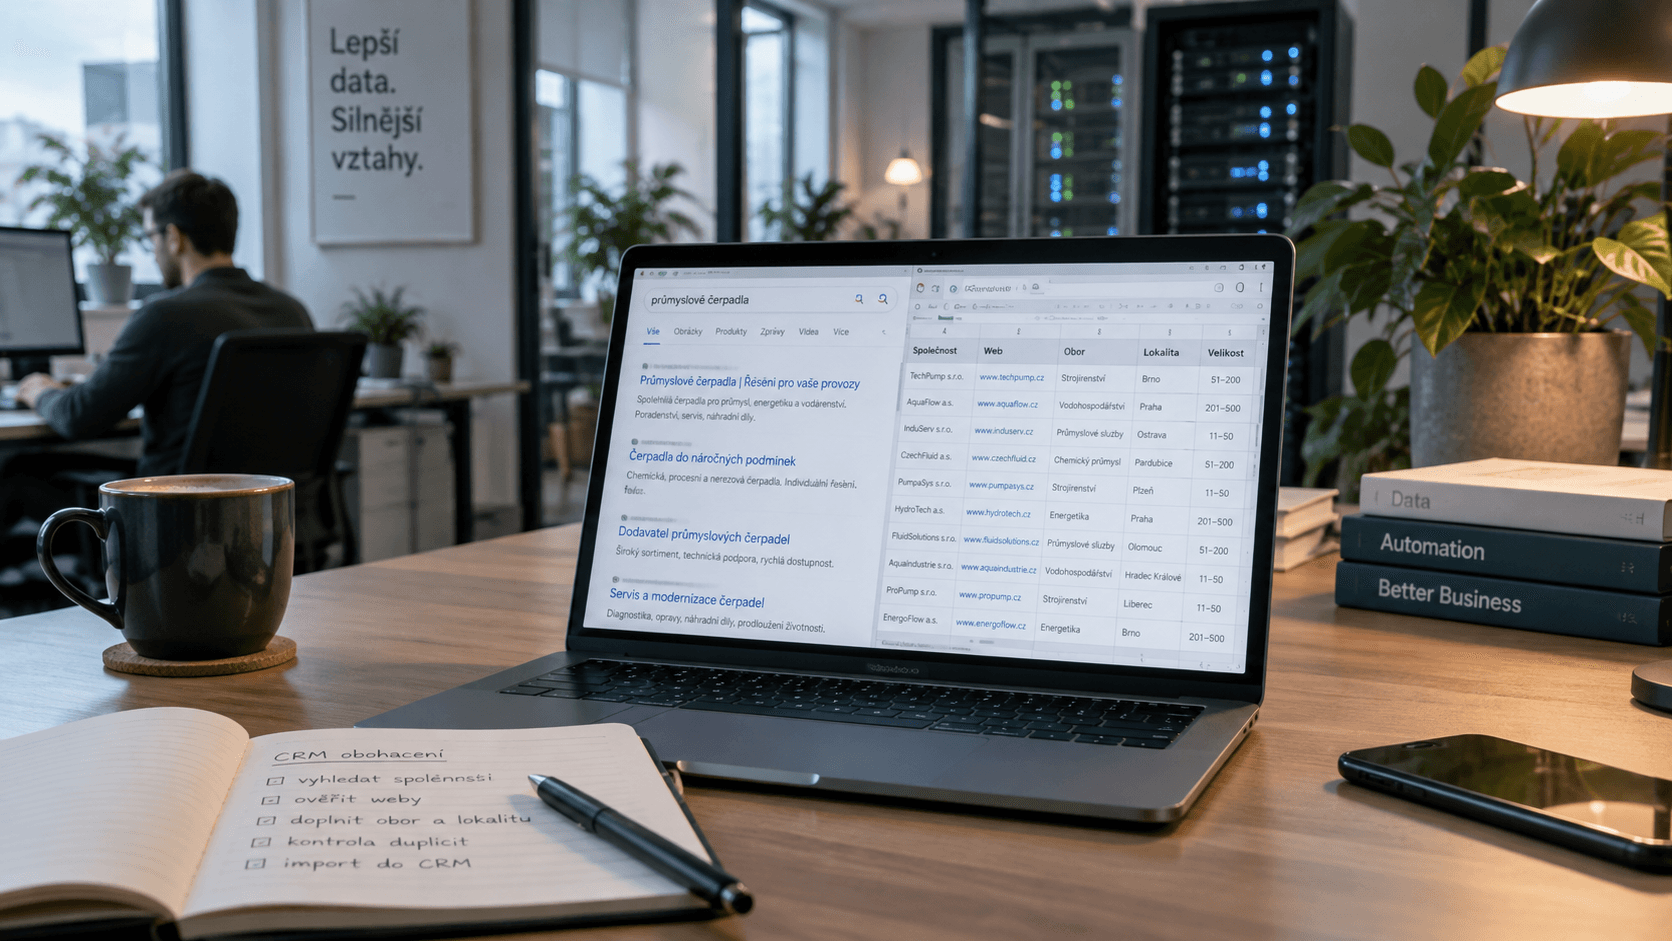
Agent, který doplňuje firemní záznamy do CRM, nemusí čekat hlavně na jazykový model. Často čeká na hledání podkladů. Proto bych vedle výběru modelu měřil i vyhledávací krok: kolik stojí, co najde a kolik dalších pokusů po něm následuje.
Perplexity 24. září 2026 představilo Photon, vlastní vyhledávací a řadicí engine, a Fast Search. Firma uvádí 68% snížení odhadovaných nákladů modelu a vyhledávání na šesti agentních benchmarcích při srovnatelné souhrnné úspěšnosti. Jde o měření dodavatele; rychlá varianta má slabší výsledky u širších a nejednoznačných dotazů. Výzkumný článek, datum publikace.
Cena hledání není cena hotové práce
Podle ceníku stojí samostatné Search API 1 USD za 1 000 úspěšných Fast Search požadavků proti 5 USD u standardu. Platí se za požadavek, i když nenajde výsledky; samotné Search API nemá další tokenový poplatek. Generování navazujícího modelu počítejte zvlášť.
Při 10 000 požadavcích je to 10 místo 50 USD. Úspora vyhledávací položky je tedy 80 %, nikoli uváděných 68 % celého benchmarku. Pokud ale rychlé hledání vede k opakování dotazů nebo chybnému firemnímu profilu, výsledek workflow může být dražší. Mě zajímá cena jednoho správně doplněného záznamu.
Jak bych to zapojil do n8n nebo Make
Následující postup je návrh pilotu, ne popis již provedeného nasazení:
- Z CRM vezměte veřejný název a známou doménu firmy. Do vyhledávání neposílejte celý interní obchodní případ.
- Přes HTTP krok vyhledejte oficiální web a podklady k jednomu konkrétnímu poli, třeba oboru nebo sídlu.
- Extraktor vrátí hodnotu, zdrojovou URL, datum kontroly a stav „doloženo / nejasné“. Nenalezený údaj zůstane prázdný.
- Při rozporu domén, záměně firem nebo nedostatku podkladů zkuste standardní hledání. Po jednom opakování předejte záznam člověku.
- Do CRM zapisujte až po validaci. Uložte původní hodnotu a identifikátor operace, aby opakování workflow nepřepisovalo záznam znovu.
Tím oddělíte nalezení podkladu od rozhodnutí, co se smí zapsat. Stejný princip se hodí pro rešerši do content pipeline nebo dohledání veřejné dokumentace pro support. Na klasifikaci interního e-mailu bez potřeby webu bych vyhledávání vůbec nepřidával.
Nastavení a jedna integrační past
V HTTP požadavku POST https://api.perplexity.ai/search nastavte search_type na fast. Návratový formát zůstává stejný; bez parametru se používá web. Fast Search není Agent API preset fast. Python SDK 0.43.4 a 0.43.5 vyžaduje extra_body={"search_type": "fast"}. Dokumentace Fast Search.
Pro první pilot bych použil HTTP uzel se zabezpečenými credentials a malou sadou záznamů. Tím lze odděleně ověřit odpověď služby a případnou chybu knihovny. Ukázku zde neprezentuji jako otestované volání z produkčního účtu.
Co musí pilot ukázat
Vezměte například 100 ručně zkontrolovaných firem, včetně shodných názvů a chybějících webů. Porovnejte oba režimy na stejné sadě: správnost polí, podíl předání člověku, počet pokusů, celkovou cenu a čas do dokončení. U zdrojů ukládejte i datum; aktuální web není záruka aktuálního údaje.
Levnější retrieval bych nasadil tam, kde tyto výsledky obstojí. Pokud se úspora ztratí v opravách, ponechal bych standardní hledání nebo upravil rozhodovací pravidla. Přínos Photonu pro firmu se rozhodne až v tomto testu.