SEO pro AI: přístupný web, který agenti dokážou číst i ovládat
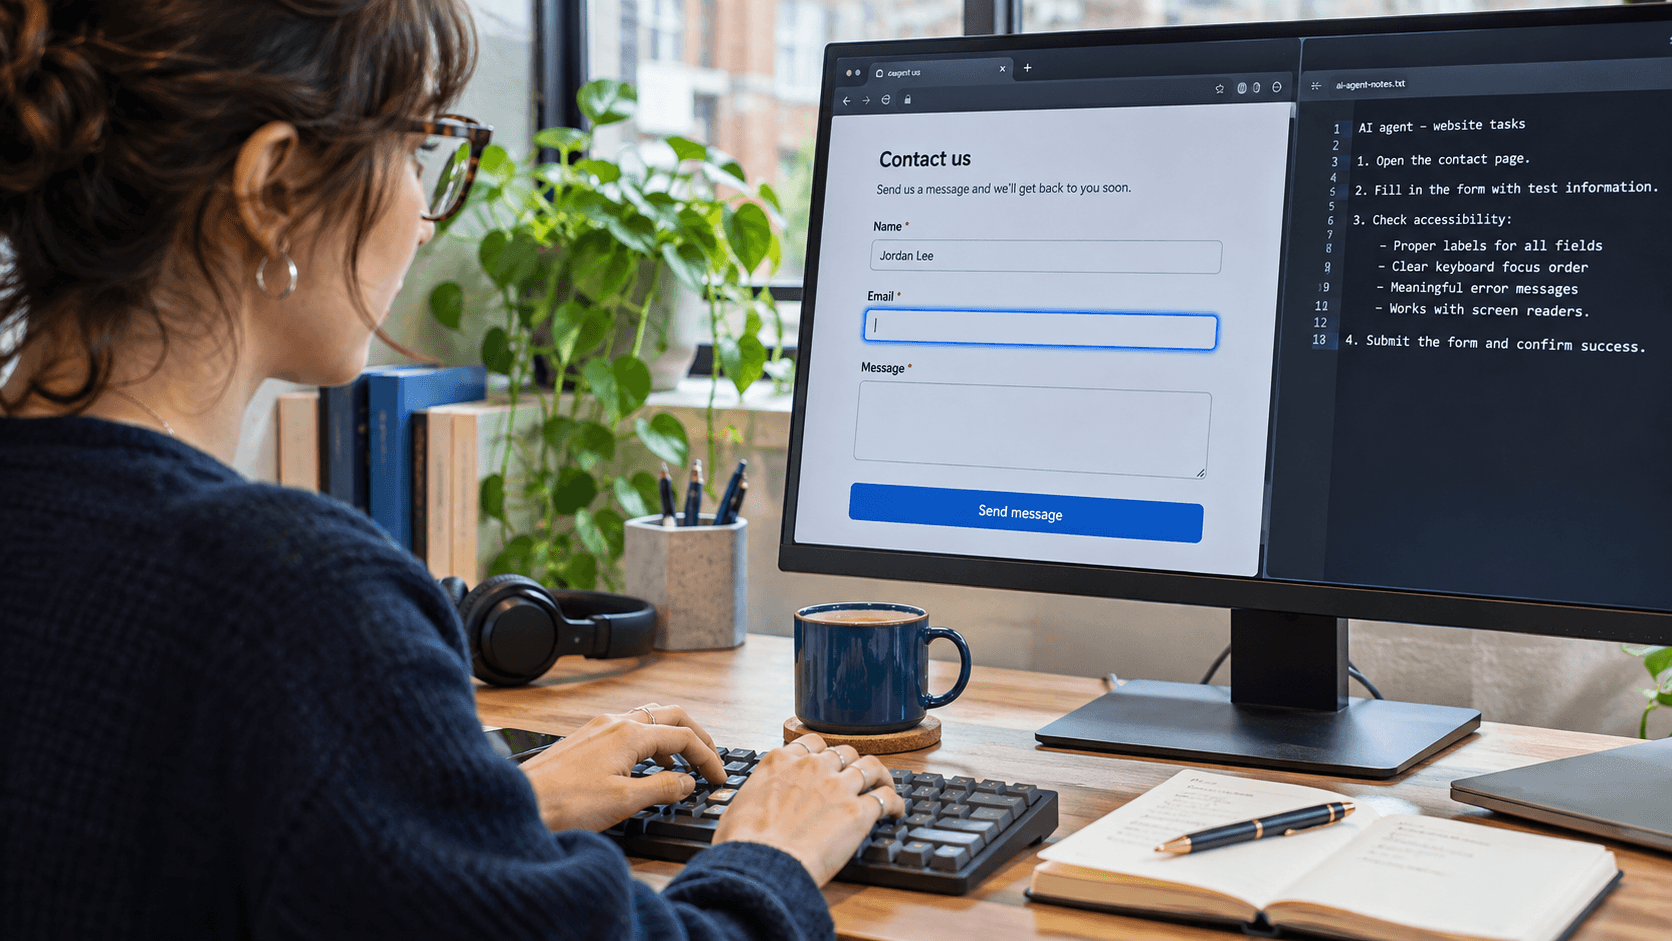
SEO pro AI začíná u dobře udělaného webu. Podle mě je poctivé SEO důležitější než kdy dřív: stránku už nečte jen člověk, ale také vyhledávač a agent, který za něj hledá informace nebo vyplňuje formulář. Základ je pořád stejný — kvalitní obsah, dostupnost, srozumitelná struktura a ovladatelnost.
Google potvrzuje, že i jeho generativní vyhledávání stojí na základech SEO. Vyšší důležitost je moje praktické hodnocení, ne naměřený růst váhy konkrétního ranking faktoru. Přidání „AI souboru“ samo o sobě lepší pozici nezajistí.
Pět nejdůležitějších praktik pro web, který má AI najít a správně přečíst
Těchto pět bodů bych použil jako pořadí práce. První čtyři zlepšují samotný web; pátý přidává pohodlnější cestu pro nástroje, které ji podporují.
1. Zajistěte, že se k obsahu vůbec dostanou
Klíčové veřejné stránky musí vracet skutečný obsah a HTTP 200, být dostupné z interních odkazů a nemít omylem nastavené noindex. Pro navigaci používejte skutečné odkazy <a href="…"> s popisným textem, ne jen JavaScriptové klikání. Sitemapu berte jako doplněk, nikoli náhradu propojeného webu.
Prověřte robots.txt i CDN/WAF: přihlašovací nebo CAPTCHA obrazovka může čtecímu nástroji uzavřít jinak veřejný článek. Rozlišujte vyhledávací, trénovací a uživatelem spuštěné boty; kvůli dohledatelnosti není nutné plošně povolit trénování. Test: načtěte veřejnou URL bez přihlášení a zkontrolujte odpověď i serverové logy. Pouhá změna User-Agentu skutečného crawlera neověří. Google: procházení odkazů, přehled botů OpenAI
2. Dejte odpověď do čitelného textu a logické struktury
Na začátku stránky vysvětlete, co řeší a pro koho. Důležité údaje nabídněte už v HTML; ne pouze v obrázku, canvasu nebo po několika interakcích. Používejte konkrétní nadpisy, přirozené odstavce, seznamy kroků a tabulky pro skutečné srovnání. Neexistuje univerzální „AI délka odstavce“.
Místo „výhodný tarif“ napište cenu, měnu, období, co zahrnuje a jaké má limity. Agent pak nemusí spojovat chybějící podmínky z různých částí webu. Test: z textového výpisu stránky musí jít správně zjistit cenu, podmínky a hlavní závěr. Bing doporučuje jasné nadpisy, příklady, data a zdroje pro přesnější použití obsahu v AI odpovědích. Bing: AI Performance
3. Udržujte jednoznačné, aktuální a doložené informace
Každé stránce dejte výstižný title, hlavní nadpis a stabilní URL. U duplicit určete kanonickou verzi; jazykové varianty propojte správným hreflang. Uvádějte autora, zdroje tvrzení a datum skutečné obsahové aktualizace. Neměňte datum každý den jen kvůli dojmu čerstvosti.
JSON-LD pro Article, Organization nebo Product používejte podle skutečného typu stránky a podporovaných pravidel. Nesmí obsahovat jinou cenu či hodnocení než viditelný web. Sjednoťte fakta mezi ceníkem, článkem a Markdownem. Test: tři reprezentace stejné nabídky musí vrátit stejnou odpověď. Přesný lastmod v sitemapě pomáhá oznámit změnu; není příslibem nového crawlu. Google: sitemap, doporučení Bing
4. Dejte prvkům význam a umožněte celý úkol bez myši
Používejte nativní tlačítka, odkazy a formulářová pole s popisky. Přidejte smysluplné alternativy obrázků, správné nadpisy, viditelný focus a srozumitelné chyby. Nevidomý uživatel ani agent nemají hádat, co znamená nepojmenovaná ikonka nebo zda formulář uspěl.
Test: proveďte poptávku přes Tab, Shift+Tab a příslušné aktivační klávesy, potom čtečkou. Zkontrolujte názvy a stavy prvků ve stromu přístupnosti. Tento bod přináší konkrétní oporu agentům používajícím stejnou strukturu; sám o sobě není ranking trik. Podrobný checklist následuje níže.
5. Nabídněte objevitelný Markdown a ověřte jeho využití
Zachovejte kvalitní HTML a přidejte synchronní .md verzi s typem text/markdown, odkazem rel="alternate" a běžným odkazem pro čtenáře. Zachovejte celý význam článku, zdroje a funkční URL; nevyrábějte pro boty jiná tvrzení než pro lidi. Vyjednávání přes Accept je další možnost, nikoli podmínka.
Test: porovnejte obsah obou verzí a v logu sledujte úspěšné požadavky na Markdown. Oddělte vlastní testy, ověřené boty a neověřené User-Agenty. Potom samostatně měřte citace a návštěvy z AI — existence ani stažení souboru ještě nedokazují lepší doporučování.
Přístupnost pomáhá lidem i strojům
Postupy pro nevidomé uživatele a čtečky obrazovky mají další využití. Prohlížeč ze stránky vytváří strom přístupnosti: prvky mají roli, název a stav. Na těchto informacích mohou stavět i automatizační nástroje. Playwright například poskytuje snímky tohoto stromu.
Z toho plyne praktický přínos pro agenty pracující s DOM nebo stromem přístupnosti: mohou rozpoznat „tlačítko Odeslat poptávku“ místo odhadování významu klikacího obdélníku. U agentů pracujících pouze se screenshoty je přínos méně přímý. Přístupnost není záruka úspěchu každého agenta; především slouží lidem.
Co bych na webu kontroloval:
- Strukturu: logické nadpisy, oblasti
mainanav, seznamy, hlavičky datových tabulek a správný jazyk dokumentu. Přidejte odkaz pro přeskočení navigace. W3C: struktura stránky - Obrázky: informační obrázek potřebuje výstižný
alt; dekorace máalt="". Obrázkové tlačítko potřebuje název své funkce. Graf doplňte textovým vysvětlením nebo daty, která samotný krátký alt nevystihne. W3C: obrázky - Formuláře: skutečný
labelpropojený s polem, vhodný typ vstupu, jasně označené povinné údaje a chyby přiřazené ke konkrétním polím. Placeholder nenahrazuje popisek. W3C: popisky - Ovládání: celý úkol musí jít dokončit bez myši. Tab a Shift+Tab přesouvají focus v logickém pořadí; Enter, mezerník a šipky fungují podle typu prvku. Focus musí být vidět. Dialog nesmí uživatele uvěznit a po zavření má focus vrátit na smysluplné místo.
- Stav a výsledek: změna dostupnosti, chyba nebo úspěšné odeslání nemají být sdělené jen barvou. Dynamická oznámení zpřístupněte čtečkám, například vhodným
role="status". Preferujte nativní HTML prvky; ARIA doplňujte tam, kde je potřeba.
U poptávkového formuláře to znamená, že člověk i agent poznají, které pole chybí a zda se poptávka skutečně odeslala. W3C: formuláře a ovládání klávesnicí jsou lepší výchozí bod než nový „AI plugin“.
Markdown: užitečná druhá verze článku
Na svém webu nabízím články i na stejné adrese s příponou .md. Například běžný článek má Markdown verzi.
Při kontrole 3. listopadu 2026 měla HTML odpověď 121 333 bajtů, Markdown 21 298 — asi o 82 % méně. Jde o nekomprimovaná těla odpovědí, nikoli naměřenou úsporu tokenů. Čtecí nástroj může HTML už sám čistit.
Někteří boti Markdown prokazatelně stahují. Dries Buytaert v měsíčním měření zaznamenal 1 300 požadavků OAI-SearchBot na .md. GoodBarber popsal i pokusy o neexistující Markdown adresy před jejich nasazením. To ale nedokazuje, že přípona automaticky přinese citace.
Jak to udělat správně:
- Generovat HTML a Markdown ze stejného zdroje a aktualizovat je současně.
- Vrátit skutečný Markdown s
Content-Type: text/markdown; charset=utf-8, zachovat nadpisy, odkazy, popisy obrázků a důležitá metadata. - Z HTML zveřejnit alternativu; nespoléhat, že bot příponu uhodne:
<link rel="alternate" type="text/markdown"
      href="https://ai.ondrej-pech.cz/cs/blog/chatgpt-work-claude-cowork-pracovni-os.md">
- Přidat i běžný odkaz „Číst jako Markdown“. Při kontrole mého článku tato vazba v načteném HTML chyběla — samotný endpoint tedy ještě neznamená dobře objevitelnou verzi.
- Volitelně podporovat
Accept: text/markdownna původní URL. Při vyjednávání formátu nastavitVary: Accepta odpovídající cache, aby prohlížeč nedostal omylem Markdown. Tento postup používá Vercel.
Co ještě udělat a co nepřeceňovat
Důležitá fakta, ceny a podmínky bych nechal jako text dostupný už v HTML. Strukturovaná data musí odpovídat viditelnému obsahu. Zkontrolujte indexaci, interní odkazy, sitemapu i firewall: povolení crawleru v robots.txt nepomůže, když ho zablokuje server.
Změny lze hlásit zapojeným vyhledávačům přes IndexNow. Například publikace ve Strapi spustí n8n workflow, které oznámí změněné CS/EN/SK adresy. Jde o upozornění na změnu, ne záruku indexace.
Vracejte správné HTTP stavy: neexistující stránka 404, omezení požadavků 429. Pro API použijte srozumitelné strukturované chyby. Pro skutečné akce se může hodit API či MCP s oprávněními a ochranou před dvojím odesláním. WebMCP ukazuje směr strukturovaných nástrojů v prohlížeči; pro blog bych mu zatím nedával přednost před těmito základy.
llms.txt může posloužit jako rozcestník podporujícím nástrojům. Nemá ale doloženou univerzální hodnotu pro pořadí v AI odpovědích. Ani Markdown není ranking trik: experiment Profound na 381 stránkách neprokázal statisticky významný nárůst návštěv botů. Měřil návštěvy, nikoli citace.
Kolik požadavků snese jeden archiv?
Jedno otevření matriční knihy v prohlížeči a deset agentů procházejících stovky snímků jsou pro archiv dvě různé zátěže. Český projekt rodokmen-skill pro Claude Code proto ve verzi 0.6.0 z 2. listopadu zavedl společný limit pro všechny procesy na jednom počítači, zvlášť pro každý archiv. Při známkách přetížení umí stahování na půl hodiny pozastavit. Historie projektu · Ukázka tématu v AI Mastermind
Podobný problém vznikne, když několik běhů n8n současně doplňuje firmy do CRM ze stejného katalogu. Samotná prodleva uvnitř každého běhu součet požadavků neuhlídá. Dejte požadavky pro daný zdroj do společné fronty, opakované čtení stejné stránky obslužte z mezipaměti a při odpovědi 429 pozastavte celou frontu podle hlavičky Retry-After, pokud ji server posílá. Jednoduchý test je spustit dva importy současně a v logu ověřit, že oba dodržují jediný limit.
První krok: dokončit úkol bez myši
Vyberte tři úkoly: najít cenu, porozumět nabídce a odeslat testovací poptávku. Projděte je klávesnicí, čtečkou obrazovky a vybraným agentem. Automatický audit doplňte ruční kontrolou; žádný z těchto testů sám nepotvrzuje úplnou přístupnost.
Opravte nejprve překážky. Potom doplňte objevování Markdownu a měřte ověřené přístupy botů, citace, návštěvy a skutečně dokončené poptávky odděleně. Stažení souboru ještě není doporučení firmy.
Směr vidím v kombinaci kvalitního obsahu, přístupného rozhraní a jasných nástrojů pro akce. Nejlepší příprava na AI agenty začíná tím, že web dobře funguje pro lidi — včetně těch, kteří ho nevidí nebo nepoužívají myš.