Lokálni AI agenti: Ollama v Claude Code a Codexe, dáta aj limity
Aktualizácia 24. septembra 2026: vlastný model v známom agentovi cez Ollama
Filip Oborník vo videu z 23. septembra ukazuje užitočné oddelenie: aplikácia agenta nemusí určovať poskytovateľa modelu. Pre tento článok som overil terminálový postup v dokumentácii. Dátum videa nie je doloženým dátumom prvého vydania integrácie.
Ollama pripája Claude Code cez Anthropic-kompatibilné API. Integrácia Codex CLI používa samostatný profil a katalóg modelov. Po inštalácii Ollama a príslušného CLI spustite jednu z možností:
ollama launch claude
ollama launch codex
Vo výbere skontrolujte model aj miesto inference. Ollama ponúka tiež cloudové modely, takže príkaz sám osebe nepotvrdzuje lokálne spracovanie. OpenAI dokumentuje aj vlastných model providerov a Ollama pre OSS režim.
Obe integrácie odporúčajú aspoň 64k kontextu. Dlhé okno však musí zvládnuť hardvér. Podľa FAQ príkaz ollama ps ukáže beh na GPU, CPU alebo ich kombinácii. Fungujúci chat ešte nepreukazuje spoľahlivé používanie nástrojov a úpravy súborov.
Pilot na citlivom repozitári
Začal by som izolovanou kópiou interného parsera faktúr a anonymnými testovacími vstupmi. Agent má opraviť jednu chybu, spustiť testy a vrátiť diff. Nemá mať účtovné prihlasovacie údaje ani právo odosielať dokumenty.
Zaznamenajte model, kvantizáciu, kontext, čas, počet opráv a výsledky testov. Sledujte aj opakovanie dokončenej práce. Ak sa výsledok nezlepšuje, slučku zastavte; lacná inference môže spotrebovať drahý čas na review.
Pri citlivých dátach prejdite celý tok: modelový endpoint, MCP, vyhľadávanie, sieťové nástroje a cloudový fallback. Sieťové obmedzenia nastavujte mimo promptu. Lokálna inference nezabráni samostatnému nástroju odoslať dokument von.
Integrácia zjednodušuje výmenu modelu a pilot na vlastnom hardvéri. Nenahrádza firemnú gateway s rozpočtami, správou prístupov a auditom. Nižšie zostávajú staršie prípadové štúdie; ich výsledky a ceny patria k uvedeným dátumom.
Aktualizácia 2. septembra 2026: lokálna AI je najmä rozhodnutie o dátach, nie trik na lacnejšie tokeny
Nový praktický test Jirku Herníka posúva tento článok od coding benchmarku k otázke, ktorú vo firmách riešim častejšie: čo robiť, keď agent potrebuje faktúry, e-maily, bankový export alebo interné dokumenty, ktoré nechcete posielať do bežného cloudového chatu.
V teste bežal Qwen3.8‑27B v štvorbitovej kvantizácii na RTX 3090 s 24 GB VRAM. Lokálny model cez Unsloth Studio a OpenCode spracoval CSV s históriou platieb a vytvoril HTML dashboard. Po odpojení internetu pokračoval ďalej. Je to dôležitý dôkaz uskutočniteľnosti, nie univerzálny benchmark: ide o jednu zostavu, jednu úlohu a konkrétne nastavenie.
Anonymizácia nie je vymazané meno
Najprv treba oddeliť tri rôzne stratégie:
- Anonymizácia má znemožniť identifikáciu človeka prostriedkami, ktoré možno rozumne očakávať. Nestačí odstrániť meno, ak kombinácia mesta, profesie, veku a nezvyčajného správania človeka stále prezradí.
- Pseudonymizácia nahradí identifikátor napríklad číslom zákazníka, no prevodná tabuľka zostáva oddelene. Podľa EDPB sú pseudonymizované údaje stále osobnými údajmi a GDPR sa na ne naďalej vzťahuje.
- Lokálne spracovanie drží prompt, dokumenty aj inferenciu na vlastnom zariadení. LM Studio uvádza, že pri lokálnom behu sa správy, história a dokumenty zo zariadenia neprenášajú; aplikácia môže po predchádzajúcom stiahnutí modelu fungovať offline.
Tieto stratégie sa môžu kombinovať. n8n môže pred lokálnou extrakciou nahradiť rodné čísla internými ID, lokálny model vytvorí štruktúrovaný JSON a až schválený súhrn sa odošle do CRM. Samotná pseudonymizácia však z cloudového spracovania neurobí anonymnú ani bezrizikovú operáciu.
Tri prostredia, nie dve
Praktická voľba nie je iba cloud verzus vlastný počítač:
- Vlastný hardvér drží dáta aj inferenciu vo vnútri vašej hranice. Dáva zmysel pre citlivé dokumenty, opakovanú extrakciu, interné vyhľadávanie alebo prevádzku bez internetu.
- API sa nasadzuje a škáluje najjednoduchšie. Pri citlivých dátach musíte riešiť poskytovateľa, región, retention, zmluvy a nástroje, ktoré agent smie volať.
- Prenajaté GPU môže byť lacnejšie než kúpa hardvéru, ale nie je lokálne. Dáta opúšťajú vašu infraštruktúru a bezpečnostný model sa podobá cloudu.
Lokálna aplikácia navyše nemusí znamenať lokálny workflow. Webové vyhľadávanie, cloudový fallback, telemetria alebo vzdialené MCP môžu časť dát preniesť za hranicu. Pre skutočne citlivý beh preto nastavte egress pravidlá, vypnite nepotrebné nástroje a logujte, kam agent komunikuje.
Výkon sa nezmestí do jedného čísla
Model card Qwen uvádza 27 miliárd parametrov, natívny kontext 262 144 tokenov, možnosť rozšírenia k jednému miliónu a licenciu Apache 2.0. To však neznamená, že každú konfiguráciu pohodlne spustíte na každom 24GB GPU. Do VRAM sa musia zmestiť kvantizované váhy, KV cache, kontext a réžia inferencie.
V predchádzajúcom teste sa štvorbitový model zmestil do 24GB RTX 3090, no pri dlhšej agentnej slučke stratil priebežný stav a opakoval hotovú prácu. Nový test ukázal rovnakú hranicu z inej strany: pri extra vysokom reasoning sa model zacyklil na formátovaní čísla, minul kontext a spustila sa kompaktácia. Perzistentný task state, acceptance test a stop podmienka sú preto rovnako dôležité ako veľkosť modelu.
Kedy sa vlastné GPU zaplatí
Vo videu vytvoril rovnaký dashboard cloudový GLM‑5.3‑Flash približne za 0,20 Kč. Beriem to ako údaj z jednej case study, nie ako cenník. OpenRouter aktuálne uvádza akciovú cenu 0,075 USD za milión vstupných a 0,25 USD za milión výstupných tokenov; cena sa môže zmeniť.
Ak kupujete GPU iba preto, aby ste ušetrili pár centov na občasnom workflow, návratnosť bude slabá. Lokálna prevádzka sa zvyčajne obhajuje inou kombináciou:
- dáta nesmú opustiť zariadenie alebo firemnú sieť,
- workflow beží často a v stabilnom objeme,
- potrebujete nízku a predvídateľnú latenciu,
- internet alebo externé API nemusia byť dostupné,
- rovnaký hardvér využije viac procesov, nielen jeden občasný agent.
Do kalkulácie patrí nákup hardvéru, elektrina, chladenie, správa, čas pri chybách, ľudské review a fallback. Správnou metrikou nie je cena tokenu ani tokeny za sekundu, ale cena schváleného výsledku.
Ako by som to nasadil
Pri faktúrach, e-mailoch alebo CRM enrichment by som začal malým pilotom:
- Spíšte, ktoré polia sú citlivé a ktoré smú opustiť vašu hranicu.
- Pripravte 50–100 reprezentatívnych dokumentov vrátane výnimiek.
- Spustite lokálny model cez LM Studio alebo Unsloth Studio za OpenAI-kompatibilným API.
- Výstup držte v štruktúrovanom JSON, kontrolujte schému a ukladajte auditnú stopu.
- Nízku istotu alebo drahú výnimku pošlite človeku; cloudový fallback používajte iba pre polia, ktoré smú odísť.
- Porovnajte cenu, latenciu a chybovosť na dokončený a schválený prípad.
Lokálna AI teda nie je automaticky lacnejšia ani automaticky bezpečná. Je to iná prevádzková hranica. Ak ju doplníte o obmedzené nástroje, sieťové pravidlá, perzistentný stav a merateľné acceptance testy, môže byť pre citlivé firemné workflow veľmi praktická.
Zdroj novej case study: Jirka Herník – Ako na AI na vašom počítači.
Aktualizácia 21. augusta 2026: silnejší lokálny model narazil na kontext, nie na syntax
Jirka Herník sa k Tetris testu vrátil s výrazne silnejšou zostavou: Qwen3.8‑27B v kvantizácii Q4_K_M, RTX 3090 s 24 GB VRAM, LM Studio a opencode. Podľa jeho merania sa 17,74GB model na tejto karte dostal približne na 800 tokenov za sekundu pri spracovaní vstupu a 40 tokenov za sekundu na výstupe. Beriem to ako praktickú case study konkrétnej zostavy, nie ako univerzálny benchmark.
Dôležitejší než rýchlosť je spôsob zlyhania. Agent podľa testu písal Tetris znova a znova, pretože pri zaplnení kontextu používal LM Studio politiku truncateMiddle. Tá ponechá systémový prompt a prvú používateľskú správu, ale zahadzuje správy uprostred. Model teda mohol stále poznať pôvodné zadanie, no stratil informáciu, že už aplikáciu vytvoril a čo má teraz overovať.
To zodpovedá oficiálnej dokumentácii LM Studia: pri pretečení možno generovanie zastaviť (stopAtLimit), skrátiť stred konverzácie (truncateMiddle) alebo držať posuvné okno (rollingWindow). Žiadna voľba sama o sebe neurobí dlhého agenta spoľahlivým. Musíte vedieť, ktorá časť histórie môže zmiznúť, a pracovný stav uložiť mimo chatu.
Oficiálny model card Qwen3.8‑27B uvádza 27 miliárd parametrov, natívny kontext 262 144 tokenov a možnosť rozšírenia až na milión. To však nie je to isté ako kontext, ktorý skutočne pobeží v lokálnej kvantizácii na konkrétnej karte. V praxi do limitu vstupuje VRAM, nastavenie servera, KV cache aj agentné nástroje.
Čo z toho nastaviť v reálnom workflow
- Kontextovú dĺžku a overflow politiku nastavte vedome; nespoliehajte sa na default.
- Plán, dokončené kroky a otvorené chyby ukladajte do repozitára alebo štruktúrovaného task state, nielen do konverzácie.
- Pridajte stop podmienku: ak agent opakovane mení tie isté súbory a nezlepšuje testy, slučku ukončite a eskalujte.
- Merajte cenu za dokončenú úlohu vrátane opakovaní a ľudskej kontroly, nielen tokeny za sekundu alebo cenu modelu.
- Lokálny model púšťajte najprv na izolovanej úlohe s automatickým acceptance testom a cloudovým či ľudským fallbackom.
Nový test teda neposúva záver článku smerom k „lokálne modely už nahradili cloud“. Posúva ho inam: model je len jedna časť agentného systému. Silnejšia GPU a novšie váhy pomôžu, ale bez perzistentného stavu, správnej práce s kontextom a verifikácie môžete iba rýchlejšie opakovať tú istú chybu.
Zdroj case study: Jirka Herník – Naklonoval jsem se 10x, AI Mastermind 36.
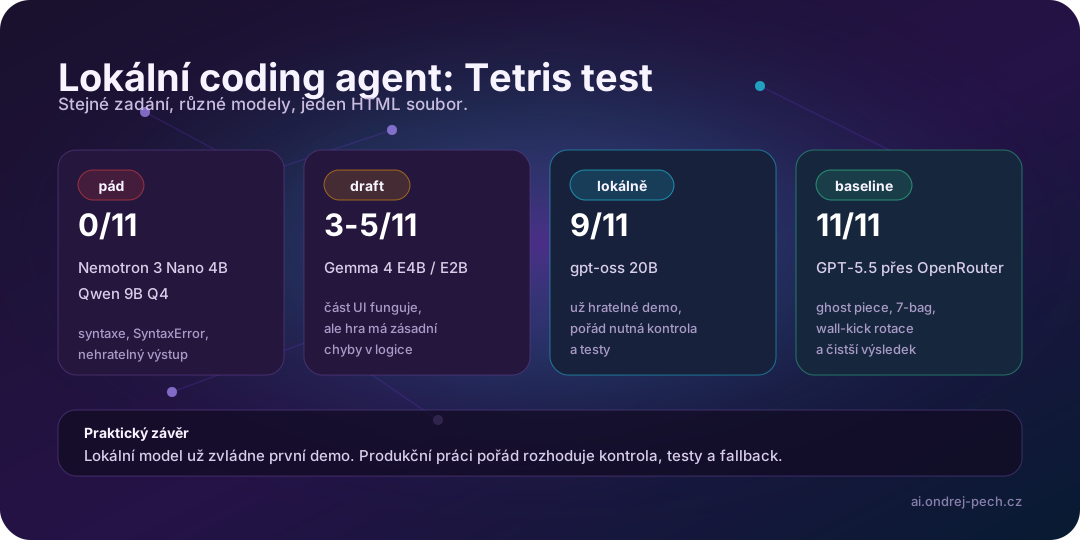
Jirka Herník 16. mája 2026 spravil presne ten typ testu, ktorý je pre AI prax často užitočnejší než ďalšia abstraktná benchmarková tabuľka: šesť lokálnych modelov, jedna cloudová baseline a pre všetkých rovnaké zadanie. Napíš Tetris ako jeden HTML súbor.
Bežalo to na silnej, ale stále realistickej domácej pracovnej stanici: Ryzen 9 5950X, RTX 3070 s 8 GB VRAM, 128 GB RAM a LM Studio ako lokálny server. Do toho opencode ako coding agent, Playwright MCP na kontrolu v prehliadači a GPT-5.5 cez OpenRouter ako referenčný cloudový výsledok.
Prečo je to dobrý test
Tetris nie je enterprise aplikácia, ale je lepší test než ďalšia TODO appka. Model musí udržať stav hry, rotácie, kolízie, vykresľovanie, časovanie, vstup z klávesnice a chyby v JavaScripte. Keď má výsledok bežať ako jeden HTML súbor, nie je sa veľmi kam schovať.
Čo dopadlo zle
Najmenšie modely narazili rýchlo. Nemotron 3 Nano 4B podľa videa vrátil Pythonovskú syntax v JavaScripte a skončil na 0/11. Qwen 9B Q4 spadol na SyntaxError a tiež skončil na 0/11.
To neznamená, že tieto modely sú zbytočné. Je to pripomienka, že „lokálna AI“ nie je jedna kategória. Model, ktorý dobre odpovedá v chate alebo zvláda jednoduchú extrakciu, ešte nemusí byť použiteľný ako coding agent, ktorý má vytvoriť funkčnú interaktívnu aplikáciu.
Kde už lokálny model začína dávať zmysel
Zaujímavejší je stred. Gemma 4 E4B skončila na 3/11 a Gemma 4 E2B na 5/11, hoci pri nej nebola viditeľná aktívna kocka. Znie to komicky, ale pre prax je to dôležité: lokálny model sa už môže hodiť na návrhy, menšie úpravy, jednoduchý refaktoring, vysvetlenie kódu alebo prvý draft.
Skutočne zaujímavý výsledok bol gpt-oss 20B. Ten podľa testu zvládol 9/11 a hra bola naozaj hrateľná. To je hranica, kde lokálny model prestáva byť iba hračka. Stále by som ho nepustil bez kontroly na produkčný kód, ale ako lacná prvá iterácia začína dávať zmysel.
Prečo cloudová baseline stále vyhrala
GPT-5.5 cez OpenRouter zvládla 11/11: ghost piece, 7-bag randomizer aj wall-kick rotácie. To je presne rozdiel medzi „nejako to beží“ a „rozumie tomu ako malej aplikácii“.
Praktické pravidlo je jednoduché: lokálny model môže byť lacná prvá vrstva, ale ťažké prípady, finálne review a zložitejšia architektúra stále patria silnejšiemu modelu. Nie preto, že cloud je magický. Pretože schopnosť udržať viac pravidiel a edge casov naraz je pri coding agentovi zásadná.
Ako by som to použil vo workflow
Lokálny model by som dnes použil na:
- jednoduché generovanie boilerplate,
- vysvetlenie cudzieho kódu,
- prvý návrh malej funkcie,
- rýchle refaktoringy bez citlivých dát,
- predspracovanie úloh pred drahším modelom.
Silnejší model alebo cloudovú baseline by som nechal na:
- návrh architektúry,
- zložité opravy,
- testy a edge cases,
- finálne review,
- rozhodnutia, kde chyba stojí viac než tokeny.
Záver
Tento test nie je o tom, že lokálna AI prehrala. Skôr ukazuje, že lokálna AI konečne začína byť praktická, len sa musí správne zaradiť do workflow.
RTX 3070 s 8 GB VRAM stále nie je náhrada frontier modelu. Ale už stačí na to, aby lokálny agent spravil prvý kus práce lacno a bez posielania všetkého do cloudu. Produkčná hodnota nevzniká tým, že jeden model zvládne Tetris. Vzniká tým, že máte router, testy, fallback a človeka, ktorý pozná rozdiel medzi hrateľným demom a spoľahlivým softvérom.
Zdroje: Jirka Herník: Tetris od 6 lokálních AI, LM Studio, opencode, Playwright MCP, OpenRouter, OpenAI: gpt-oss, Google Gemma, Qwen, NVIDIA Nemotron.